文章摘要
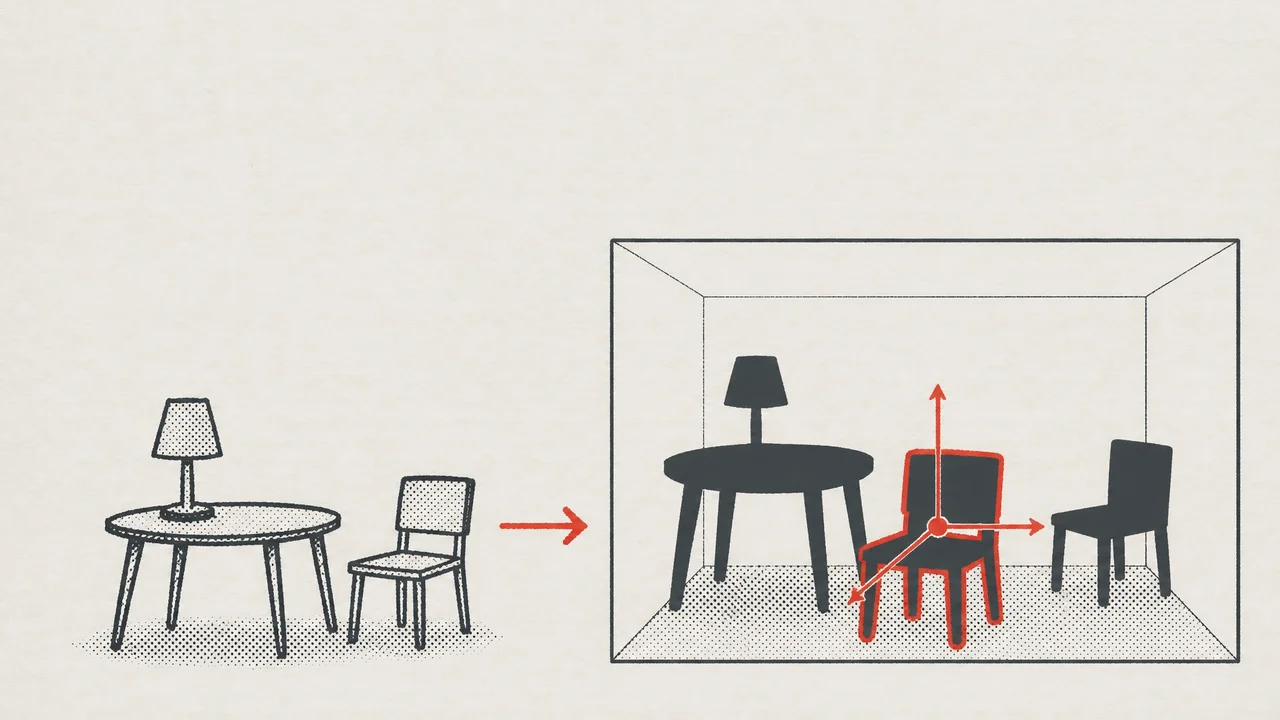
Lucida 把真实室内视频中的每个物体重建为完整、可编辑的 3D 资产,并按观察到的原样重新摆放——为机器人仿真和具身 AI 提供可直接用于仿真的环境副本。它采用 Parse(解析)→ Generate(生成)→ Place(放置)三段式流水线,把精确对齐留到最后的闭环阶段。
Lucida 指南 2026:把真实场景重建为可编辑 3D 资产(ByteDance Seed)
字节跳动 AI 研究部门 ByteDance Seed 发布了Lucida——把真实室内场景重建为完整、可编辑的物体资产并按照观察到的布局摆放的系统。论文见 arXiv:2608.30821。
先给结论:Lucida 把真实室内视频中的每个物体重建为完整、可编辑的 3D 资产,并按观察到的原样重新摆放——为机器人仿真和具身 AI 提供可直接用于仿真的环境副本。它采用 Parse(解析)→ Generate(生成)→ Place(放置)三段式流水线,把精确对齐留到最后的闭环阶段。
传统方法假设:准确的实例几何、无遮挡的视角、与观测完全匹配的资产——而杂乱的真实拍摄几乎无法提供这些。Lucida 重新分配了这些要求,让每个阶段只消费真实拍摄能稳定提供的信息。
本文介绍 Lucida 是什么、三段式流水线、GizmoAct 以及评测结果。
Lucida 是什么
Lucida 是ByteDance Seed、北京大学、浙江大学的联合研究,目标是可组合的场景建模(composable scene modeling)。
| 项目 | 内容 |
|---|---|
| 论文标题 | Lucida: Parse, Generate, and Place for Composable Real-to-Sim Scene Modeling |
| 机构 | ByteDance Seed・北京大学・浙江大学 |
| 论文 | arXiv:2608.30821 |
| 项目页 | lucida-r2s.github.io |
| 目标 | 把真实场景重建为可编辑 3D 资产(Real-to-Sim) |
| 流水线 | Parse → Generate → Place(+ GizmoAct) |
| 主要贡献 | GizmoAct(VLM 操作 3D 编辑器)、R2S 基准 |
| 应用 | 机器人仿真、具身 AI |
为什么重要:重新设计前提
现有 Real-to-Sim 流水线依赖三个前提:
- 准确的实例几何(杂乱场景中无法获得)
- 无遮挡视角(物体重叠时不可能)
- 与观测完全匹配的资产(事先并不存在)
Lucida 保留 Parse→Generate→Place 的顺序,但重新分配各阶段的要求——每个阶段只消费真实拍摄能稳定提供的信息,精度在最后达成,而不是在开头就被要求。
三段式流水线

① Parse(解析):构建场景图
从输入视频中:
- 选择信息量大的关键帧
- 跨视角关联实例(把不同视角中的同一物体关联起来)
- 构建经过验证的场景图,每个节点包含:参考视角、掩码、部分点云、3D 框、指代线索
② Generate(生成):无遮挡资产
从每个证据包中:
- 合成无遮挡的物体图像(补全被遮住的部分)
- 提升为完整、可编辑的 3D 资产
③ Place(放置):GizmoAct 闭环放置
先粗初始化资产,再让GizmoAct发出可执行的位姿编辑,直到渲染的资产与拍摄场景对齐。
GizmoAct:VLM 操作的 3D 编辑器
Lucida 的核心贡献是GizmoAct——让视觉语言模型(VLM)在闭环中操作 3D 编辑器。
- 每轮:接收渲染观测,在物体的局部坐标系发出一次可执行编辑(增量位姿更新)
- 自己决定何时停止(无需外部收敛判据)
- 9-DoF 位姿(旋转、平移、各向异性缩放),以当前物体尺寸为单位的增量更新——不回归绝对位姿
- 训练:在合成专家轨迹上监督微调 → 在同一环境中强化学习(RL)
- 从刻意设置的困难随机位姿开始训练,因此对资产不匹配和粗糙初始化都很鲁棒
评测结果:三项指标大幅提升
Lucida 在R2S、CA-1M、Aria Digital Twin三个数据集上评测。
| 指标 | Lucida | 对比 |
|---|---|---|
| R2S-Scene mAP(检测) | 0.592 | Boxer 0.351(+69%) |
| CA-1M ADD-SB@0.05(位姿) | 83.4% | 最强基线 57.8% |
| R2S-Object ADD-SB@0.05 | 92.0% | 79.2% |
| CA-1M 3D IoU | 0.607 | 0.434 |
| R2S-Object 3D IoU | 0.719 | 0.500 |
| Scene F-Score | 0.924 | SAM 3D 0.794・SceneGen 0.351 |
- 场景级 3D 物体检测:R2S-Scene 上比 Boxer 提升69% mAP(0.351→0.592)
- 物体位姿估计:CA-1M ADD-SB@0.05 57.8%→83.4%、R2S-Object 79.2%→92.0%
- 场景重建:Scene F-Score 0.924(SAM 3D 0.794、SceneGen 0.351)
- 单一策略、多种初始化鲁棒:无需重训即可处理 Boxer、Any6D*、SAM 3D 的不同误差特性
总结
Lucida 以「精度在最后的闭环达成,而不是在开头就被要求」的设计哲学,解决了 Real-to-Sim 场景重建难题。
- ✅ 把真实场景重建为完整、可编辑的 3D 物体资产
- ✅ Parse→Generate→Place 重新分配各阶段要求
- ✅ GizmoAct:VLM 操作的 3D 编辑器实现闭环放置
- ✅ 9-DoF 位姿、遮挡补全、自动停止
- ✅ 检测 +69%、位姿 +25pt、Scene F-Score 0.924
- ✅ 为机器人仿真与具身 AI 提供仿真就绪副本
正在构建机器人仿真环境、具身 AI 训练数据或 3D 场景编辑的研究者和开发者,Lucida 是 2026 年值得关注的研究。
链接
- 项目页:https://lucida-r2s.github.io/
- arXiv:https://arxiv.org/abs/2608.30821
- Hugging Face Papers:https://huggingface.co/papers/2608.30821
相关文章
2026年8月14日
【2026】dots3-note Preview 完全解析!RedNote 的 280B MoE 模型为何能与 DeepSeek V4 Flash 正面交锋
2026年8月31日
DeepSeek-V4-Flash-Vision-Exp 指南 2026:DeepSeek 首个多模态 AI 智能体模型详解
2026年9月1日
Unlimited-OCR 指南 2026:百度出品、一次解析数十页的下一代 OCR
2026年9月2日
abliterated-model-large-v2 指南 2026:基于 GLM-5.3 的拒绝向量移除模型
2026年6月25日
【2026】DS4Flash(DeepSeek V4 Flash)本地运行完全指南!最大化 96–128GB VRAM
2026年9月2日
YOLO26 指南 2026:Ultralytics 最新目标检测模型