文章摘要
与其说是 V4 Flash 的替代品,不如说是「多模态自托管版的新选项」。想继续用 API 就留在 V4 Flash;想在自有硬件上处理图像和音频,就考虑 dots3-note Preview——两者定位不同。
【2026】dots3-note Preview 完全解析!RedNote 的 280B MoE 模型为何能与 DeepSeek V4 Flash 正面交锋
只有 16B 激活参数的开源模型,真能和 DeepSeek V4 Flash、GPT-5.5 正面硬刚?
「仅 16B 激活参数,却能与 DeepSeek V4 Flash、GPT-5.5 并驾齐驱的开源模型来了。」
2026 年 8 月 14 日,RedNote(小红书)的 AI 实验室「dots studio」发布了dots3-note Preview。这是一款 280B MoE(激活 16B)、512K 上下文、支持文本/图像/视频/音频的多模态模型,以 Apache-2.0 开源权重形式发布。
最大的看点是:官方基准测试将它与 DeepSeek V4 Flash、GPT-5.5、Kimi K3、Opus 4.8 等直接对比。用很小的激活参数宣称「与大得多的模型互角以上」——这对重视成本的本地 AI 用户来说,是不容错过的一次发布。
本文基于官方技术博客、Hugging Face 模型卡和官方 X 发布的真实数据,面向初学者,从规格、基准、用法到 DeepSeek V4 Flash 用户视角的评价,进行全面解析。
读完本文你将了解:
- dots3-note Preview 的规格(280B MoE / 16B 激活 / 512K 上下文)
- 与哪些模型对比、评价如何
- 对 DeepSeek V4 Flash 用户意味着什么
- 如何自己运行(SGLang / vLLM)
- 开源权重・许可证・商用可行性
dots3-note Preview 是什么?
dots3-note Preview 是 dots3 家族首个开源权重模型,由 RedNote 的 AI 实验室「dots studio」开发。
正如「note」这个名字,它面向 long-horizon agency:长期完成现实世界中的复杂任务。「推理、探索陌生环境、随时间更新记忆、适应变化」——将多模态感知(图像、音频)与编码、工具使用结合起来,解决复杂任务。
模型规格(官方数据)
| 项目 | 数值 |
|---|---|
| 架构 | 多模态 MoE |
| 总参数量 | 280B |
| 激活参数量 | 16B |
| 上下文长度 | 512K tokens |
| 层结构 | 1 dense + 45 MoE |
| 专家数 | 256 routed + 1 shared(top-8) |
| 视觉编码器 | MoE ViT(7B 总 / 1.2B 激活) |
| 音频编码器 | Dense 800M |
| 支持精度 | BF16 / FP8 |
| 输入 | 文本・图像・视频・音频 |
| 输出 | 文本 |
| 许可证 | Apache-2.0(可商用) |
关键在于总参数量 280B,但推理时只激活 16B。参数效率极高,配合 FP8 量化版,在「单节点 8 卡 GPU」上自托管是现实可行的。
为什么受关注(3 个要点)
1. TEMPO——新的 RL 方法
dots3-note Preview 引入了TEMPO(通过自我批评与测试时缩放价值估计,进行 long-horizon agent 训练的新 RL 方法)。智能体在长时间任务中自我批评地学习,并能在测试时缩放价值估计——面向「长时间真实任务」智能体的新训练范式。
2. 512K 上下文 + 全模态输入
512K token 的上下文窗口,支持文本、图像、视频、音频输入。适合长文档处理,以及消费大量工具输出的智能体工作流。
3. 同步发布两个开源基准
同时发布了面向真实生活智能体的开源基准VibeSearchBench与VibeLifeBench,重视评测透明度。
基准对比:对手是谁
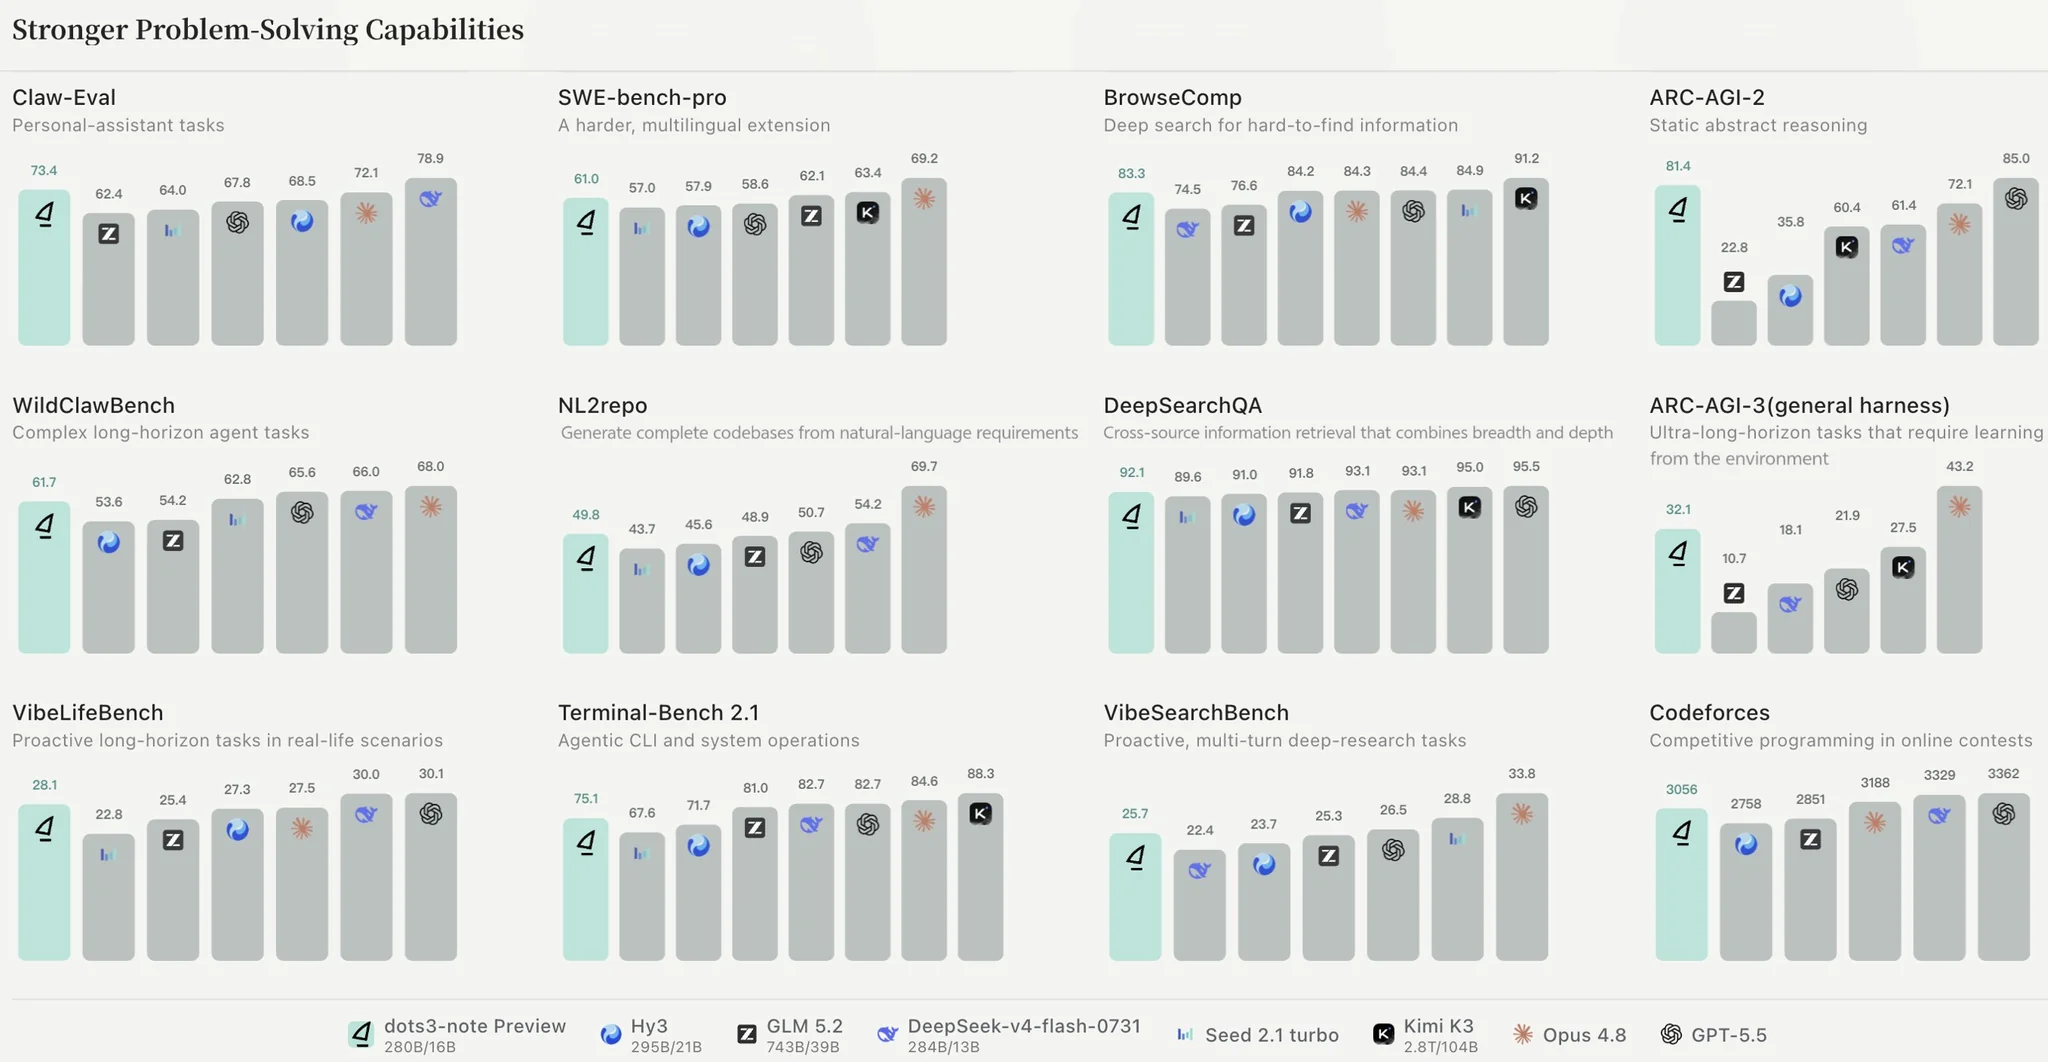
官方 X 发布的对比图分为推理/智能体与多模态两大方向。
推理・智能体方向——对比对象
| 对比模型 | 类型 |
|---|---|
| DeepSeek V4 Flash | 开源模型(API 为主) |
| GPT-5.5 | 闭源模型(OpenAI) |
| Opus 4.8 | 闭源模型(Anthropic) |
| Kimi K3 | 开源模型(Moonshot) |
| GLM 5.2 | 开源模型(智谱) |
| Hy3 | 开源模型(腾讯) |
| Seed 2.1 turbo | 开源模型(字节) |
基准:Claw-Eval / SWE-bench-pro / BrowseComp / ARC-AGI-2 / ARC-AGI-3 / WildClawBench / NL2repo / DeepSearchQA / VibeLifeBench / Terminal-Bench 2.1 / VibeSearchBench / Codeforces
多模态方向——对比对象
Seed 2.1 turbo / Qwen3.7Plus / Inkling-Small / Kimi K3 / Gemini-3.5-flash / Seed 2.0 Lite / Qwen3.5 Omni Plus
基准:WorldVQA / Charxiv-RQ / PerceptionBench / MMEVideo v2 / SimpleVQA / GDP pdf / ZeroBench@5 / MMAU-Pro
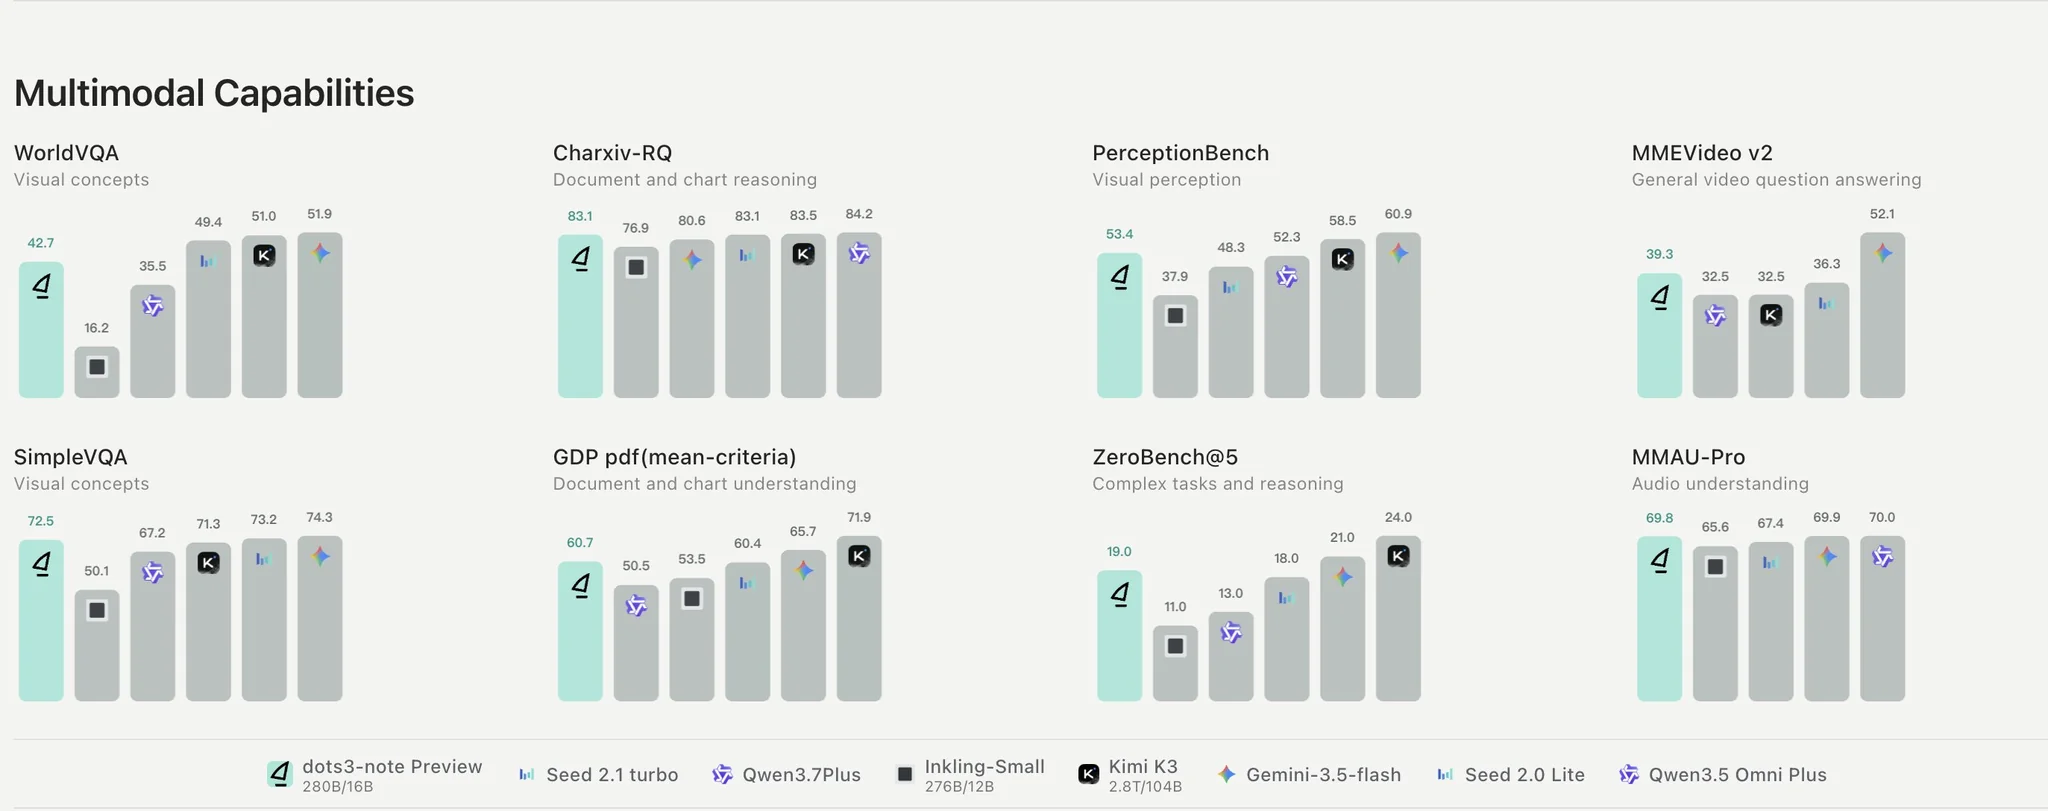
官方表述是「在推理、智能体、多模态各项评测中,与大得多的模型互角以上、具备竞争力」。具体数值请参阅上面的对比图(来源:dots studio 官方 X)。
DeepSeek V4 Flash 用户视角的评价
如果你正在用 DeepSeek V4 Flash,这个模型意味着「选择变多了」。
- 对比对象中明确包含 V4 Flash:DeepSeek V4 Flash 直接出现在官方基准的对比名单里。说明 dots studio 自信「能与 V4 Flash 一较高下」。
- 成本理念相近:V4 Flash 的卖点是「小激活参数、高效率」,而 dots3-note Preview 在此基础上还支持完整多模态(图像・视频・音频)。纯文本场景继续用 V4 Flash;还需要图像和音频的话,dots3-note 就是候选。
- 易于自托管:开源权重(Apache-2.0),可在自有 GPU 上运行。FP8 版推荐单节点 8 卡 + SGLang / vLLM。
| 对比项 | DeepSeek V4 Flash | dots3-note Preview |
|---|---|---|
| 提供方式 | API 为主(官方 API + 工具集成) | 开源权重(可自托管) |
| 参数量 | 未公开(V4 家族) | 280B 总 / 16B 激活 |
| 上下文 | 1M(官方) | 512K |
| 多模态 | 以文本为主 | 文本・图像・视频・音频输入 |
| 许可证 | API 使用条款 | Apache-2.0 |
| 自托管 | 不现实(太重) | FP8 单节点 8 卡推荐 |
结论:与其说是 V4 Flash 的替代品,不如说是「多模态自托管版的新选项」。想继续用 API 就留在 V4 Flash;想在自有硬件上处理图像和音频,就考虑 dots3-note Preview——两者定位不同。
实际使用方法
推荐配置
官方推荐:用 SGLang 或 vLLM,在单节点 8 卡 GPU 上部署 FP8 检查点。
启动 API 服务器(示例)
# vLLM
vllm serve dots-studio/dots3-note-prev-fp8 \
  --max-model-len 131072 \
  --enable-thinking

# SGLang
python -m sglang.launch_server \
  --model-path dots-studio/dots3-note-prev-fp8 \
  --context-length 131072
启动后可作为 OpenAI 兼容 API 使用:
from openai import OpenAI

client = OpenAI(base_url="http://127.0.0.1:8000/v1", api_key="EMPTY")

response = client.chat.completions.create(
    model="dots3-note-prev",
    messages=[{"role": "user", "content": "请简单自我介绍"}],
    temperature=1.0,
    top_p=0.95,
    max_tokens=256,
    # enable_thinking=True 为推理模式,False 为直接回答
    extra_body={"chat_template_kwargs": {"enable_thinking": False}},
)
print(response.choices[0].message.content)
支持的运行时
- Transformers:PR #47844 已支持
- SGLang:PR #33829 已支持
- vLLM:recipes.vllm.ai 提供官方配方
权重同时在 Hugging Face(dots-studio/dots3-note-prev 与 -fp8 版)和 ModelScope 分发。
优点与缺点
| 项目 | 内容 |
|---|---|
| 优点 1 | 激活 16B 实现 280B 级效率(成本・速度均衡) |
| 优点 2 | Apache-2.0,可商用,开源权重 |
| 优点 3 | 文本・图像・视频・音频全模态 |
| 优点 4 | 512K 长上下文窗口 |
| 优点 5 | 同步发布开源基准(VibeSearchBench / VibeLifeBench) |
| 缺点 1 | Preview 版(正式版与 Full Report 均 coming soon) |
| 缺点 2 | 自托管实际需要 8 卡级 GPU(即使 FP8) |
| 缺点 3 | 刚发布,社区信息还很少 |
读者想了解的内容
Q1. 免费吗?
模型本身是开源权重(Apache-2.0),免费下载、可商用。但运行所需的 GPU 环境(推荐:单节点 8 卡)需要另外准备。
Q2. 比 DeepSeek V4 Flash 快吗?
官方基准称「互角以上」,但实际速度取决于硬件和部署方式。激活仅 16B,推理效率设计得很好。
Q3. 日语能力强吗?
模型支持多语言,但刚发布,日语的详细评测还很少。作为中国实验室的模型,中文应该很强——目前只是推测,有待实测。
Q4. 有官方 API 吗?
官方 API 尚未公布。现阶段主要是自托管(SGLang / vLLM / Transformers)。
Q5. 需要什么 GPU?
官方推荐:FP8 版在单节点 8 卡上运行(例如 8×H100 / 8×A100 级别)。
Q6. VibeSearchBench / VibeLifeBench 是什么?
dots studio 同步发布的面向真实生活智能体的开源基准,评估搜索型真实任务与长期生活任务。
Q7. 正式版什么时候出?
未公布。目前是 Preview 版,Full Report 标注「coming soon」。
总结:适合什么人
结论:想要「多模态 + 自托管」的本地 AI 用户,现在就应该关注这个模型。
- 开源权重、可商用、16B 激活的高效设计
- 官方基准宣称与 DeepSeek V4 Flash、GPT-5.5 等互角以上
- 全模态(文本/图像/视频/音频)+ 512K 上下文
- 缺点是 Preview 版,且需要 8 卡级 GPU
以 API 为主的话继续用 DeepSeek V4 Flash。想在自有 GPU 上处理图像和音频的开源模型——这是目前最有力的候选之一。正式版与 Full Report 值得期待。
相关文章:DeepSeek V4 Flash 官方 API 完全解析!智能体性能超越 V4 Pro Preview 的冲击
相关文章
相关文章
2026年7月21日
Laguna S 2.1 深度解析:118B MoE 开源权重 AI 编程模型,如何击败比自己大 25 倍的模型(完整基准对比)【2026年版】
2026年7月28日
Kimi K3 完全指南:2.8T 全球最大开源模型,与 0.18B 超小型版(普通电脑也能跑)的全貌【2026年版】
2026年6月17日
【2026】小米 MiMo API 完全解读!与 DeepSeek 同价的多模态 AI 模型
2026年8月1日
【快讯・2026年7月31日】DeepSeek V4 Flash 官方 API 公测上线!智能体性能超越 V4 Pro Preview,原生支持 Claude Code・Codex・OpenCode・Hermes 等 6 款工具
2026年8月10日
【2026】DeepSeek V4 Flash × 8 个智能体框架完全对比!Composio 实测:Pi Agent 最便宜且任务通过最多
2026年8月6日
【2026】在 cnb.cool 免费使用 DeepSeek V4 Flash!CodeBuddy 用法图解(初学者向け)