文章摘要
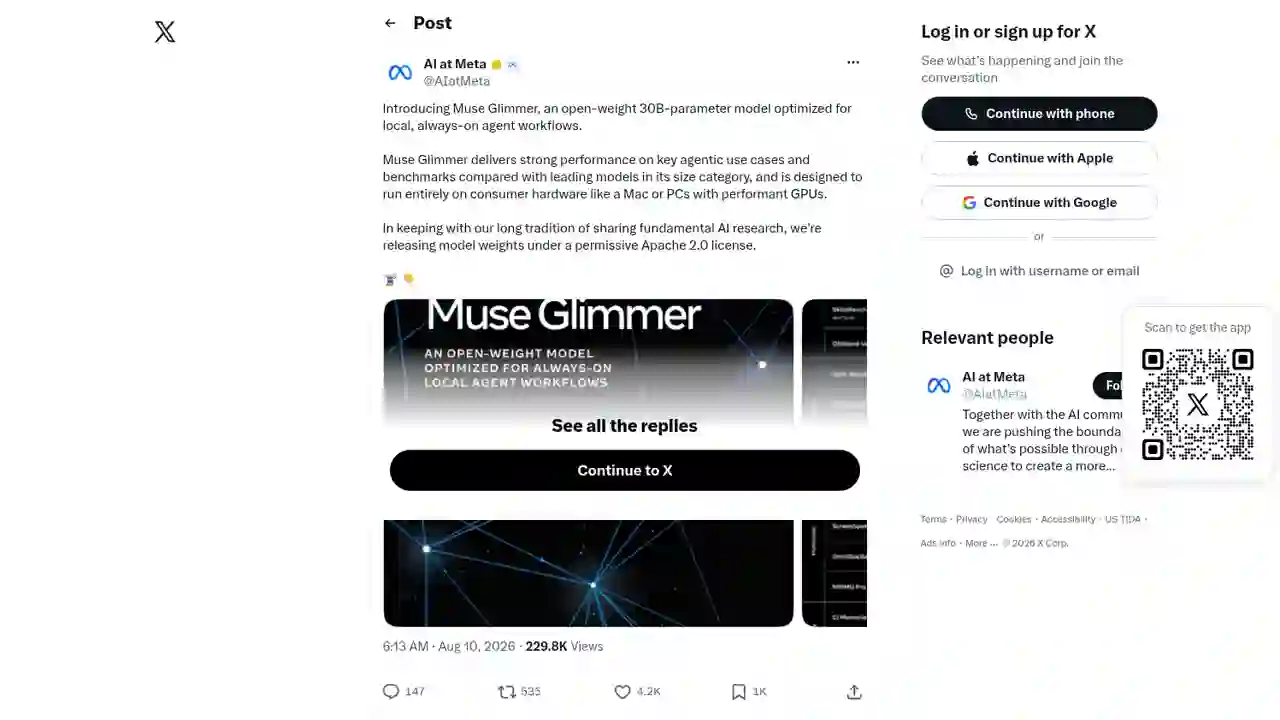
2026 年 8 月 10 日,Meta Superintelligence Labs 发布了Muse Glimmer。这是一款300 亿(30B)参数的开源模型,采用Apache 2.0 许可证完全免费公开。
【2026】Meta Muse Glimmer 完全指南!30B 开源模型正在改变本地 AI 智能体
想让 AI 智能体跑在家用电脑上、不依赖云端——这个 30B 开源模型够用吗?
「想让 AI 智能体在家用电脑上运行,但模型太重了……」 「想要不依赖云端、离线也能运行的智能体……」
Meta 给出了实现这些愿望的答案。
2026 年 8 月 10 日,Meta Superintelligence Labs 发布了Muse Glimmer。这是一款300 亿(30B)参数的开源模型,采用Apache 2.0 许可证完全免费公开。
最大特点是:专为本地 AI 智能体设计,单张消费级 GPU(24~32GB 内存)即可运行。通过量化压缩到 20GB 以下,并利用轻量级草稿模型DFlash进行投机解码,实现最高 3.1 倍的生成加速。
本文将面向初学者,完整讲解 Muse Glimmer 的性能、原理和用法。
本文你能了解到什么
- Muse Glimmer 是什么(能做什么)
- 与竞品模型的性能对比(基准测试)
- 实现本地运行的 2 项技术(量化・DFlash)
- 实际用法(llama.cpp・LM Studio・Ollama)
- 演示内容(Home Assistant 自动化)
Muse Glimmer 是什么?
Muse Glimmer 是Meta Superintelligence Labs 开发的、专为本地 AI 智能体打造的 30B 开源模型。
主要特点
- 30B 参数: 采用稠密(dense)架构,单张消费级 GPU 即可运行
- Apache 2.0 许可证: 商用、修改、再分发完全免费
- 本地优先: 离线也能运行,支持智能体、函数调用、本地编程、LLM-as-a-Judge
- 多模态: 同时接受文本和图像输入(解读截图、图表、文档)
- 支持 100 多种语言
- 推理强度可调: 可以在质量与速度之间自由选择(Controllable Effort)
在 X 上已获得4,200+ 点赞、229,000+ 浏览量,备受关注。
与竞品模型的性能对比
Muse Glimmer 与同尺寸级别的Gemma4-31B(Google)和Qwen3.6-27B(Alibaba)进行了对比。
| 类别 | Muse Glimmer | 对比对象 |
|---|---|---|
| 智能体任务 | 在 DeepSearch QA・MCP-Atlas・τ-Bench・SWE-Bench 上表现强劲 | 同尺寸级别的领先模型 |
| 工具使用 | 在整个扩展工作流中精确调用符合 schema 的函数 | 标准函数调用 |
| 多模态 | 通过专用感知编码器支持文本+图像输入 | 同类模型多以文本为主 |
| 失败恢复 | 工具调用失败时诊断并重试 | 通常会停止 |
| 多步推理 | 维持长推理链,完成复杂任务 | 标准推理能力 |
专注于智能体用途,是与同尺寸通用模型的最大区别。
实现本地运行的 2 项技术
1. 量化:55GB → 20GB 以下
全精度的 30B 模型需要55GB 以上的内存,消费级 GPU 无法运行。
Muse Glimmer 通过约 4bit 量化将模型压缩到20GB 以下。在 24GB 或 32GB 内存中,可以同时运行模型本体、KV 缓存、感知编码器和草稿模型。
| 版本 | 精度 | 内存 | 精度损失 |
|---|---|---|---|
| 全精度 | FP16/FP32 | 55GB 以上 | 基准 |
| K-Quant-Dynamic | 约 4bit 动态量化 | 20GB 以下 | 极小 |
| K-Quant-17GB | 约 4bit 量化(优化版) | 约 17GB | 约 1% |
经验证,在智能体任务上精度损失极小甚至为零。
2. DFlash:投机解码最高提速 3.1 倍
通常,LLM 是逐 Token 生成的,因此在长推理链或多步工具调用时会变慢。
DFlash是一个一次性提出整块 Token 的轻量级草稿(辅助)模型。主模型并行验证这些提议,接受正确的 Token、修正错误的 Token。输出质量保持不变,但生成速度大幅提升。
| 设备 | 提速 | 备注 |
|---|---|---|
| RTX 5090 | 3.1 倍 | 约 233 tok/s(YouTube 视频实测) |
| M5 Max | 1.8 倍 | MacBook Pro 旗舰型号 |
| M4 Max | 1.5 倍 | MacBook Pro 高端型号 |
演示:Home Assistant 仪表盘自动化
在 X 上公开的演示视频中,Muse Glimmer 仅凭一句自然语言提示,就完成了复杂的多步任务。
- 通过网络工具发现本地的Home Assistant实例
- 查询设备API(读取传感器数值等)
- 从零编写一个完全响应式的 HTML/CSS/JS 仪表盘
- 启动本地服务器并验证运行
「AI 帮你做出智能家居仪表盘」——这正是本地 AI 智能体实力的体现。
用法:现在就能试
Muse Glimmer 的权重可从 Hugging Face 免费下载。
1. llama.cpp(CLI・服务器)
# 常规运行
llama serve -hf meta-models/Muse-Glimmer-30B-GGUF

# 使用 DFlash 投机解码加速
llama serve -hf meta-models/Muse-Glimmer-30B-GGUF --spec-type draft-dflash --spec-draft-n-max 15
2. Transformers(Python)
from transformers import AutoProcessor, AutoModelForMultimodalLM

MODEL_ID = "meta-models/Muse-Glimmer-30B"

processor = AutoProcessor.from_pretrained(MODEL_ID)
model = AutoModelForMultimodalLM.from_pretrained(
    MODEL_ID,
    dtype="auto",
    device_map="auto"
)
3. 支持的工具・合作伙伴
- 本地运行: Ollama・LM Studio・Unsloth(即将支持)
- 边缘框架: llama.cpp・ExecuTorch・MLX
- 规模部署: vLLM・SGLang
- 云端: Together AI・Fireworks AI・OpenRouter
同时兼容OpenClaw等智能体编排框架。
总结
Meta Muse Glimmer 是一款有望成为本地 AI 智能体新标准的 30B 开源模型。
- 30B・Apache 2.0: 商用也完全免费的开源权重
- 量化至 20GB 以下: 单张消费级 GPU(24~32GB)即可运行
- DFlash 投机解码: RTX 5090 上最高提速 3.1 倍
- 智能体优先: 工具使用・失败恢复・多模态・长上下文
- 演示实证: 用自然语言自动生成 Home Assistant 仪表盘
想「在家用电脑上全天候运行 AI 智能体」的人,这正是值得关注的模型。从 Hugging Face 下载,亲自体验本地 AI 智能体的世界吧。
相关文章
相关文章
2026年8月6日
【2026】Muse Code 完全指南!Meta 发布的终端编码智能体与 Muse Spark 1.2 深度解读
2026年9月9日
Meta「Muse」上线!AI 代办邮件、预订、购物的个人 AI 智能体全解读(2026年版)
2026年8月20日
【2026】Berd 完全指南!Block 公司开源内部 No.1 工具「打造 AI 智能体梦幻团队」的桌面应用
2026年9月2日
2026 年 Meta Muse Spark 1.3 完全解读!编程 AI 新星 DeepSWE 75.4 超越 Opus 5
2026年9月5日
NVIDIA PAIR 是什么?2026 年免费把家里的 PC 变成「一个本地 AI 集群」的用法与设置教程
2026年7月10日
【2026】Meta Muse 完全指南!智能体型图像生成与隐私争议的全貌